Nel precedente articolo ho dimenticato di citare la prova di DeepSeek R1 8b ma comunque non cambia molto rispetto alla 7b .
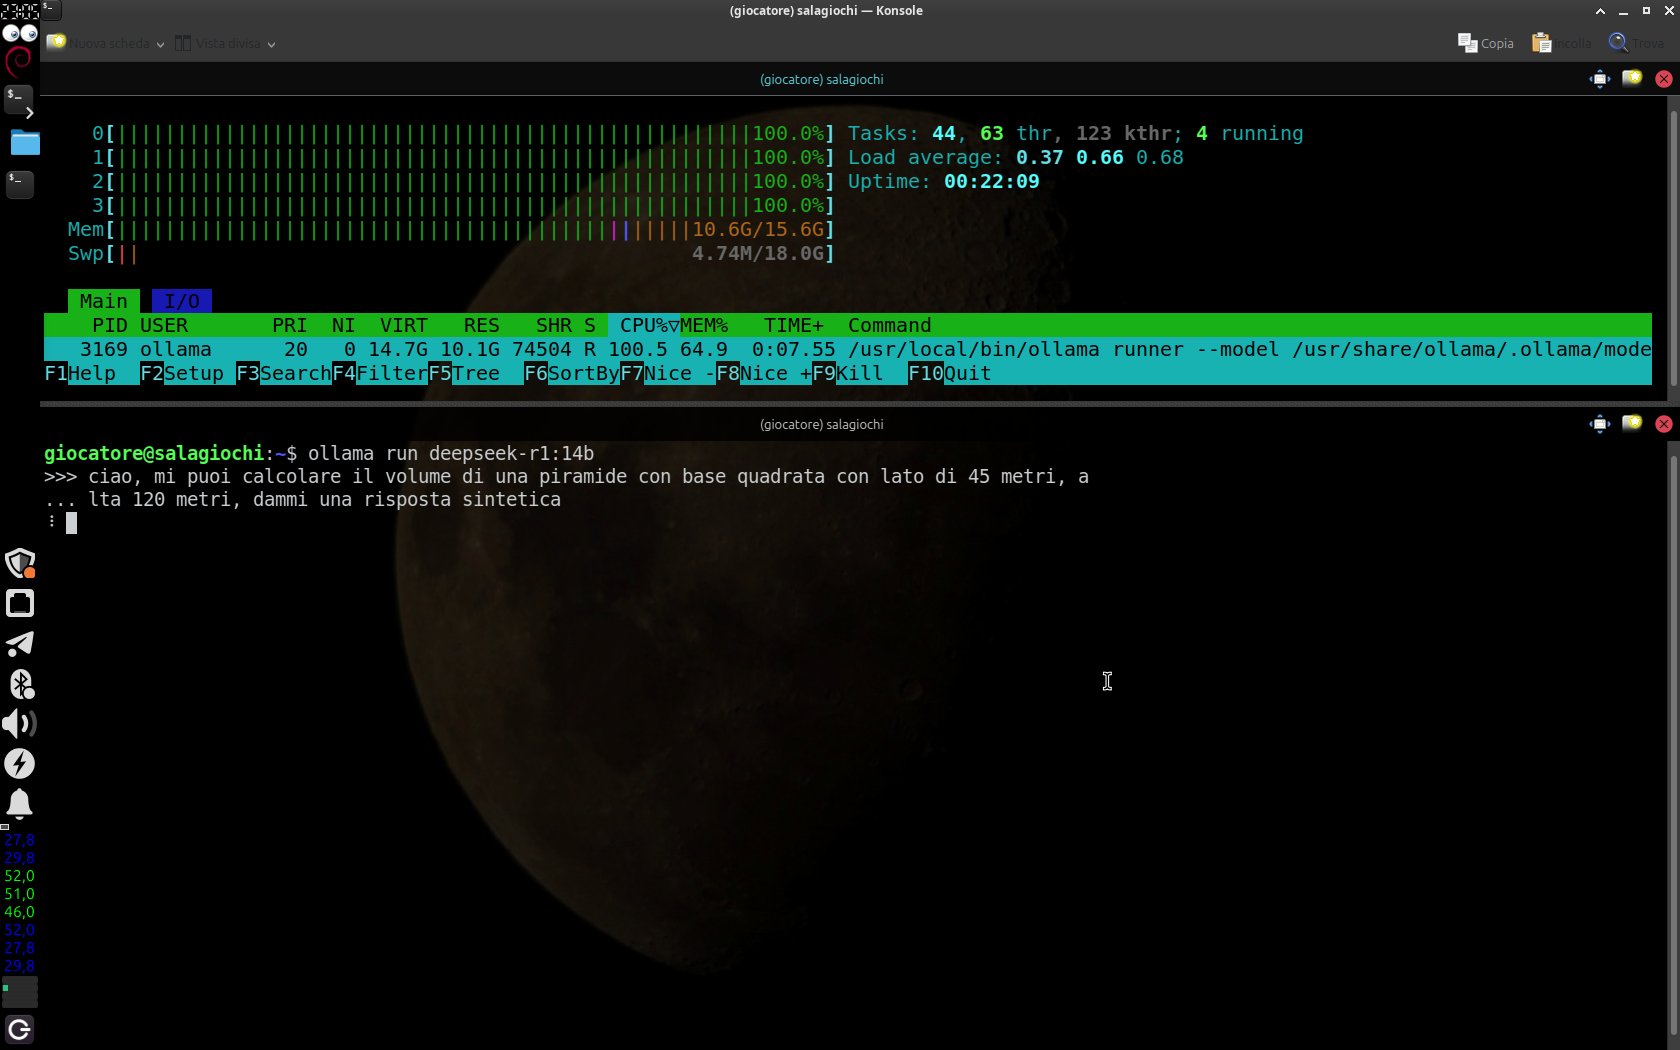
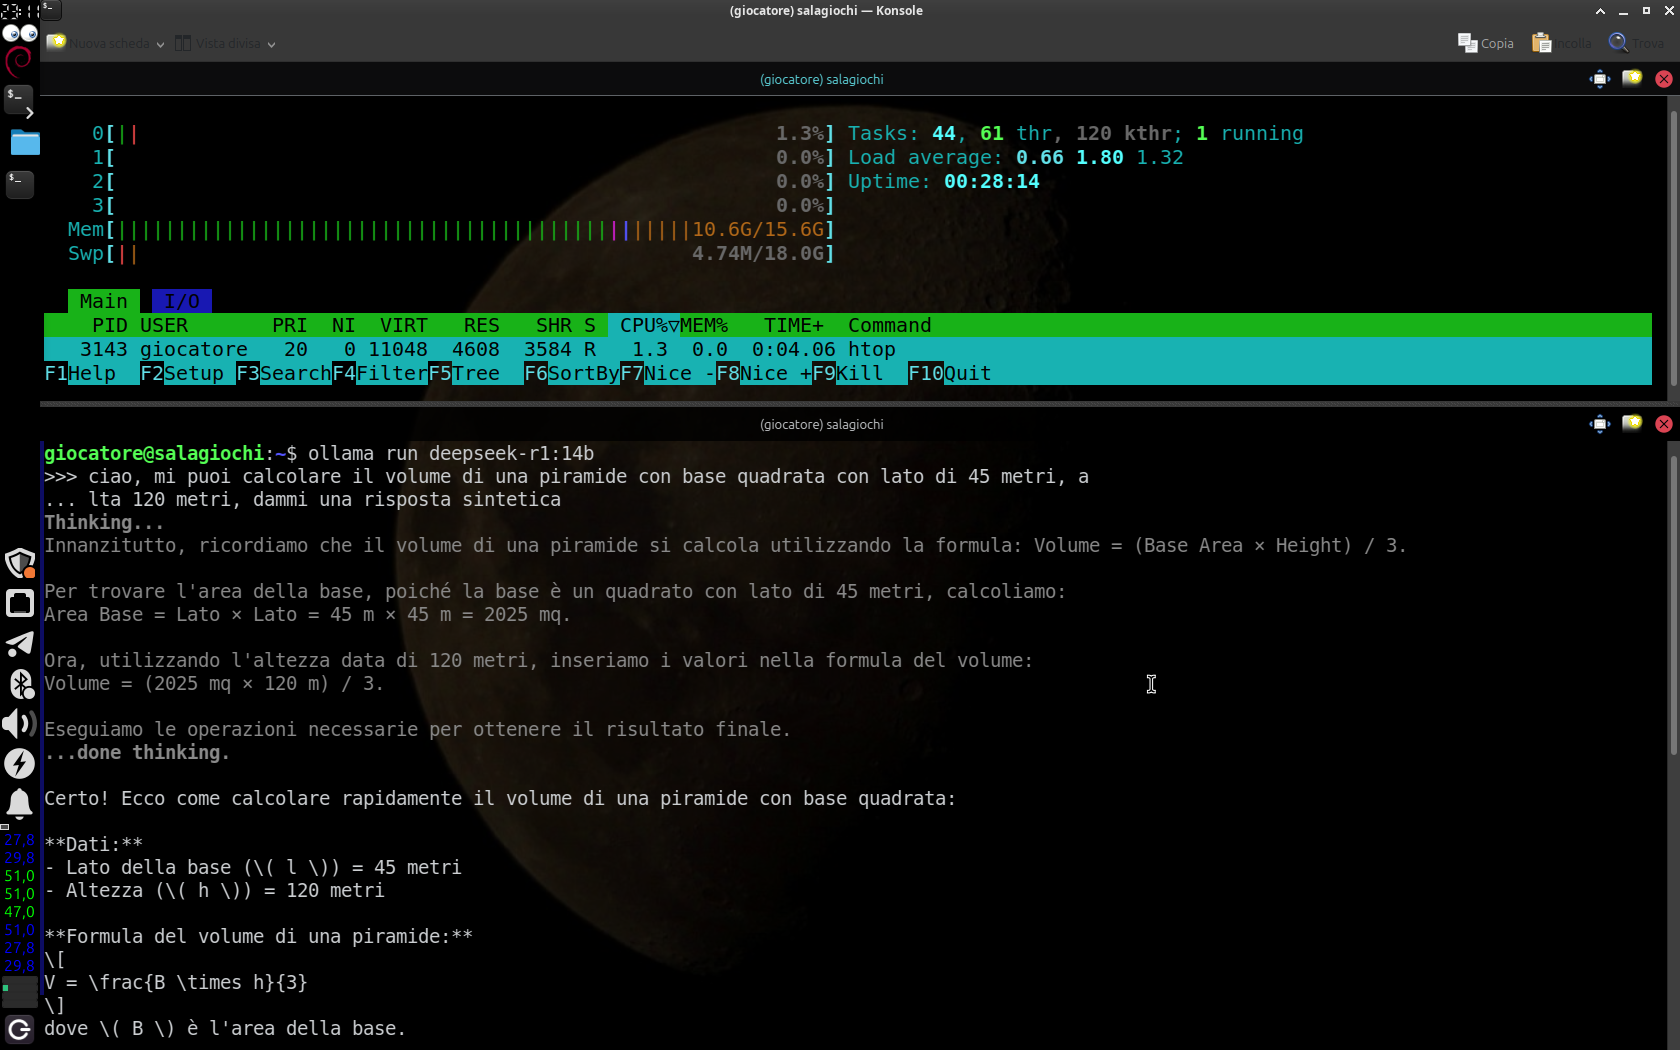
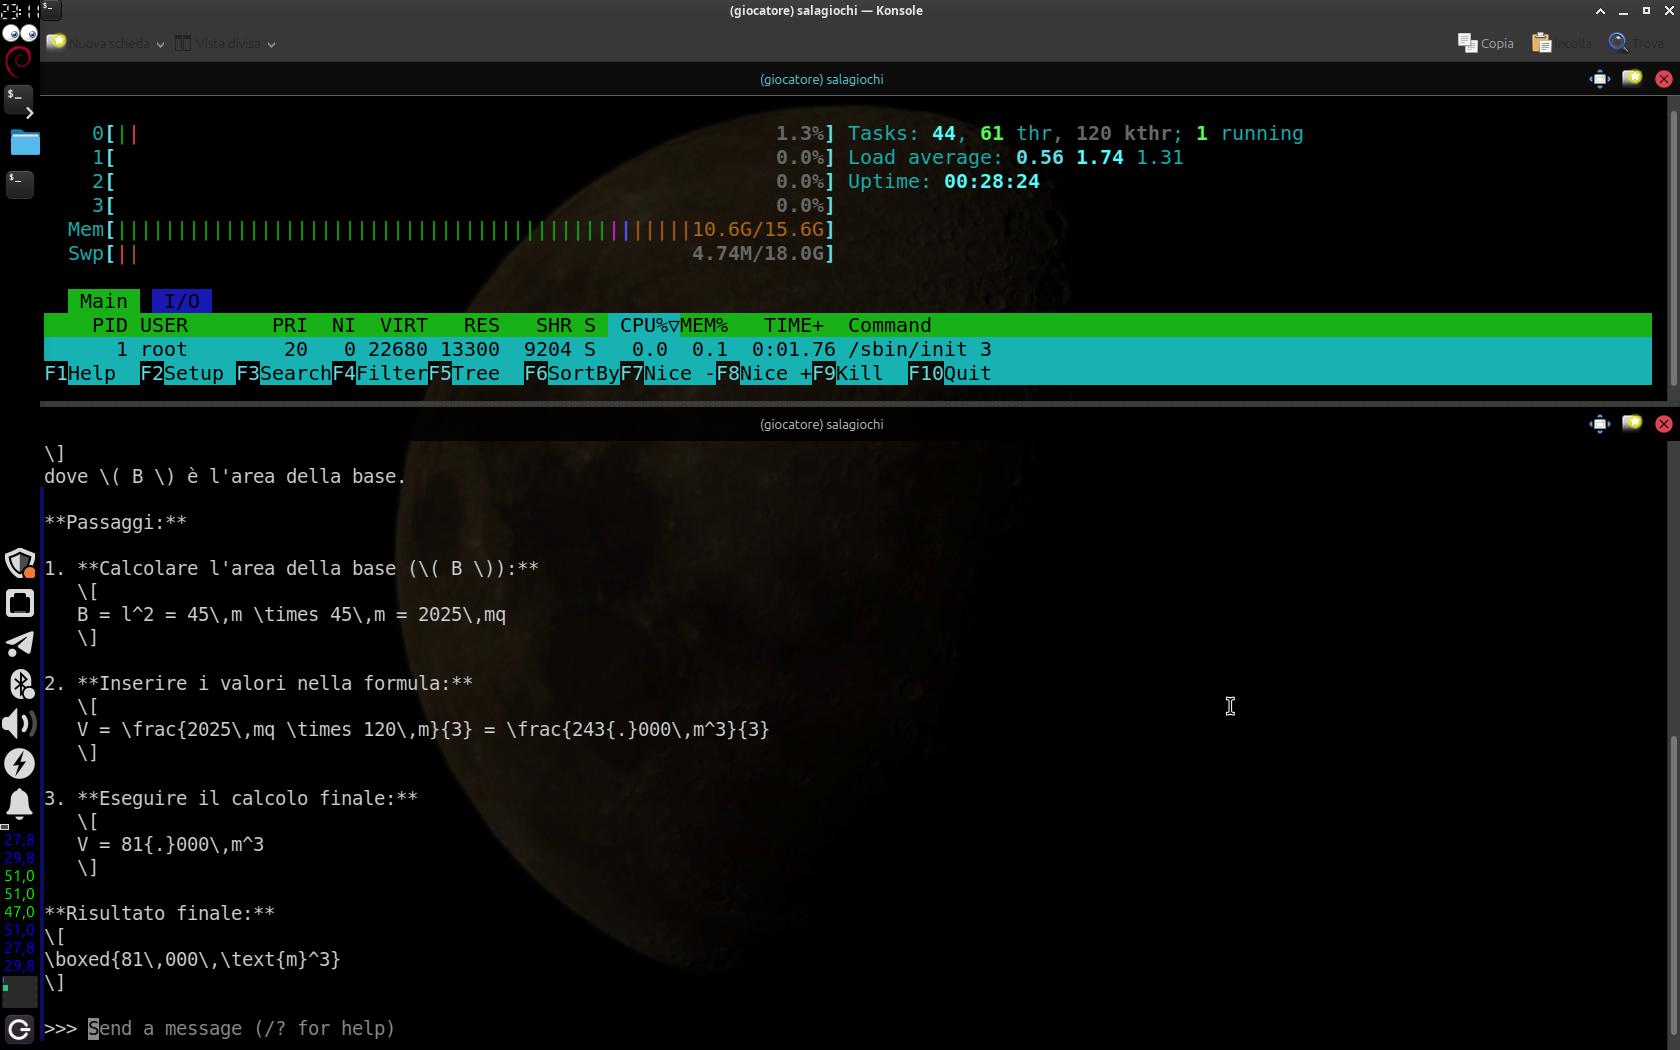
Oggi ho provato DeepSeek R1 14b
Dato che il PC Salagiochi ha 16 Gb di ram DDR3 ho voluto fare questa prova, sembra andare bene, come al solito ho fatto la domanda classica sul calcolare il volume di una piramide, come sapete le risposte in se mi interessano relaltivamente sono piu curioso di sapere come va in generale e la comprensione delle domande.
In questa prova mi sono collegato via SSH cosi da non cosumare risorse in altro 😛
Se non sbaglio il prossimo modello di DeepSeek è 27b che di sicuro è oltre le possibilità del mio HW anche per il PC bestiale che ha 20 Gb di ram.
Comunque ci sono altre LLM da provare come Gemma3:12b
se avete suggerimenti lasciate un commento.
Se volete sapere di più sul PC salagiochi vi invito a leggere gli articoli “Giocare su Linux”
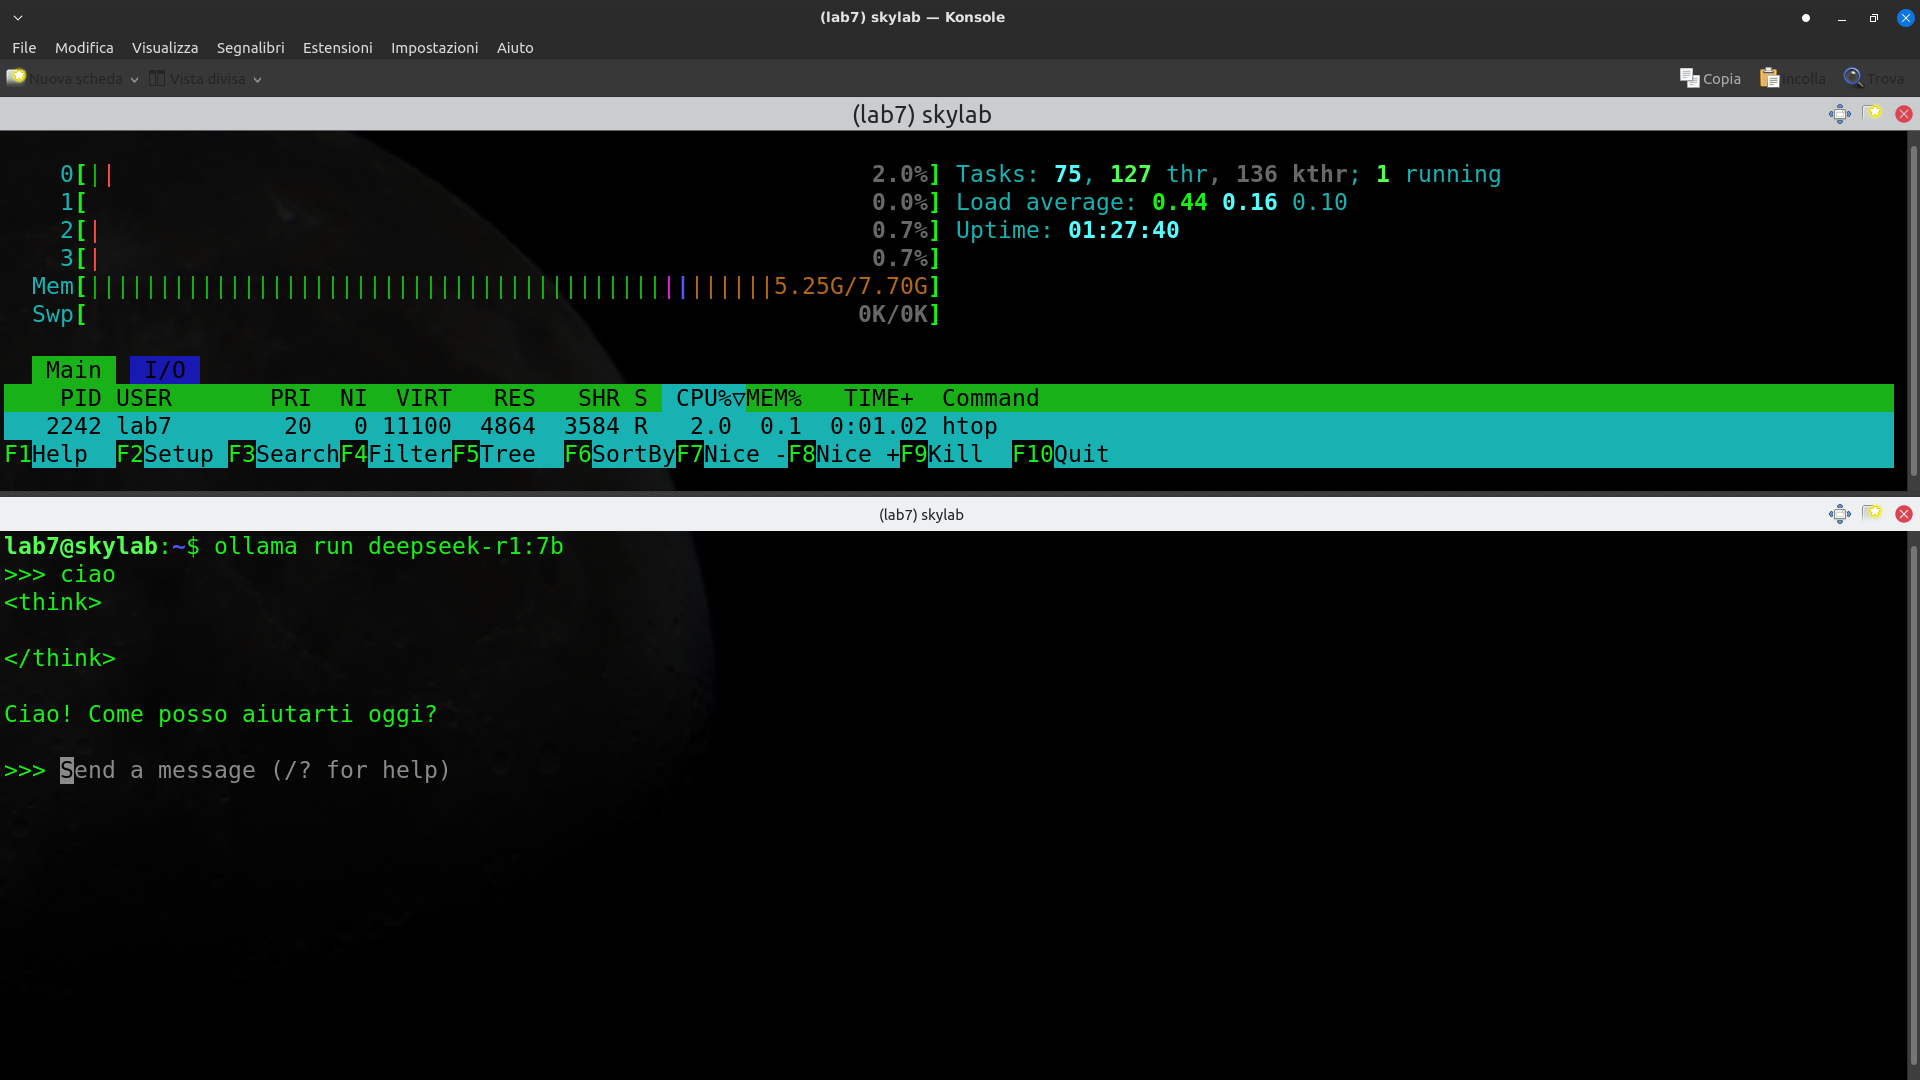
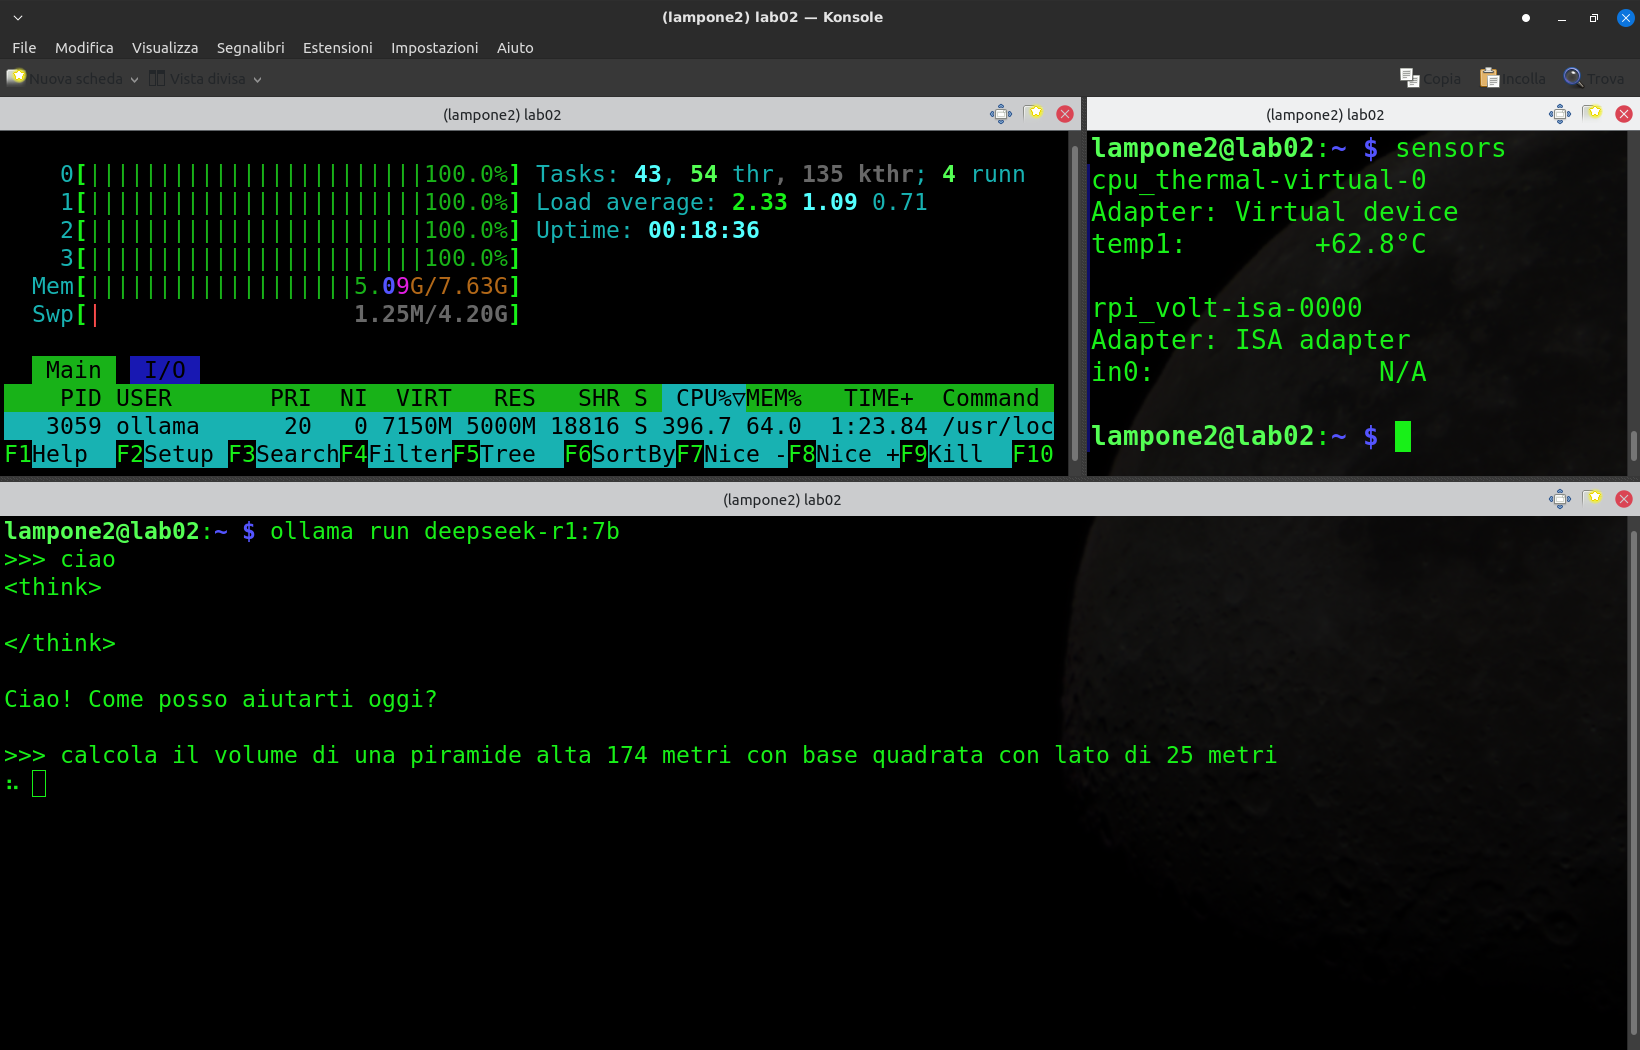
Ho provato anche la versione deepseek r1 7b (7 miliardi di parametri) che gira accettabilmente bene (ovviamente per me che sono un hobbista se ci lavorate o studiate le cose cambiano non poco) sul mio secondo pc con CPU i3 ed 8 Gb di ram.
Dalle prove fatte occupa circa 6 gb di ram su 8 la CPU sembra reggere bene, la temperatura durante l’elaborazione delle risposte rimane sui 60 gradi, e questo è gia un risultato interessante, la versione 7b rispetto alla 1,5b, provata negli scorsi giorni, ha un italiano migliore e riesce ad elaborare rispote più complesse anche se non ho fatto domande particolari.
Di solito mi limito a domande basilari come moltiplicazioni e calcolare il volume di una piramide dato che la cosa che mi interessa è il livello di comprensione delle domande.
Mi sembra anche abbastanza ovvio che il livello delle risposte e il tempo dipendano soprattutto dall’HW a disposizione.
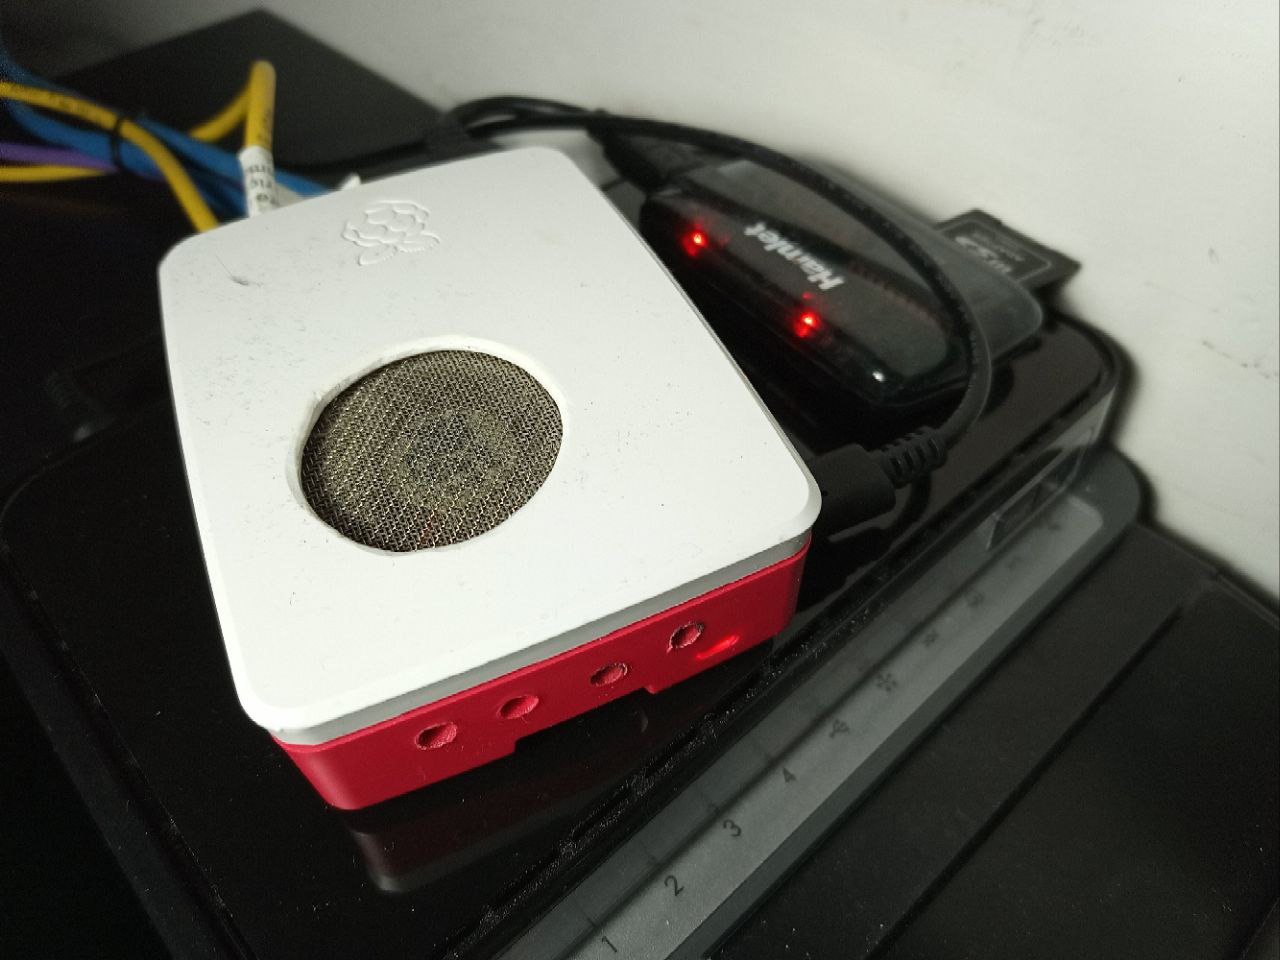
Ho fatto una prova anche sul RPi, il mio RPi5 ha 4 Gb di ram quindi ho voluto provare la versione 7b sul RPi4 che è l’unico di quelli che possiedo con 8Gb di ram, consapevole che sto comunque chiedendo qualcosa che va oltre le possibilità di questo RPi ho notato che durante l’elaborazione delle risposte la CPU è al 100% la Ram usa è circa 5.5 Gb su 8 la temperatura sui 65 gradi e ovviamente le risposte solo lente.
Ho notato anche una certa lentezza nella fase inizale quando il modello di LLM viene caricato in ram, ipotizzo che dipenda dal lettore SD usb che sto usando dato che in questo RPi quello integrato è danneggiato,
me ne farò una ragione essendo solo una prova.
In conclusione devo dire che l’idea di avere una AI che gira in locale è interessante per vari motivi di utilizzo, di privacy, ecc ecc.
Ovviamente se avete una necessita particolare potreste valutare l’idea di acquistare HW dedicato cosi da avere il controllo di cosa sta facendo l’AI e come.
II progetto Deepseek essendo opensource dovrebbe essere Forkabile (cioè crearne una variante) che si possa allenare da zero, dato che il progetto è di origine Cinese non è difficile immaginare che ci possano essere state interferenze nella scelta delle informazione con cui sia stata addestrato questa LLM, ma non entro nel merito dato che non mi sembra il momento di trattare argomenti di questo tipo.
Nel articolo precedente trovate anche i comandi per installare Ollama e Deepseek su Linux ovviamente,
ci sono diverse versioni
deepseek r1 1,5b (1,5 miliardi di parametri)
deepseek r1 7b (7 miliarci di parametri)
ecc ecc il resto del comando da terminale non cambia.
Aggiornamento:
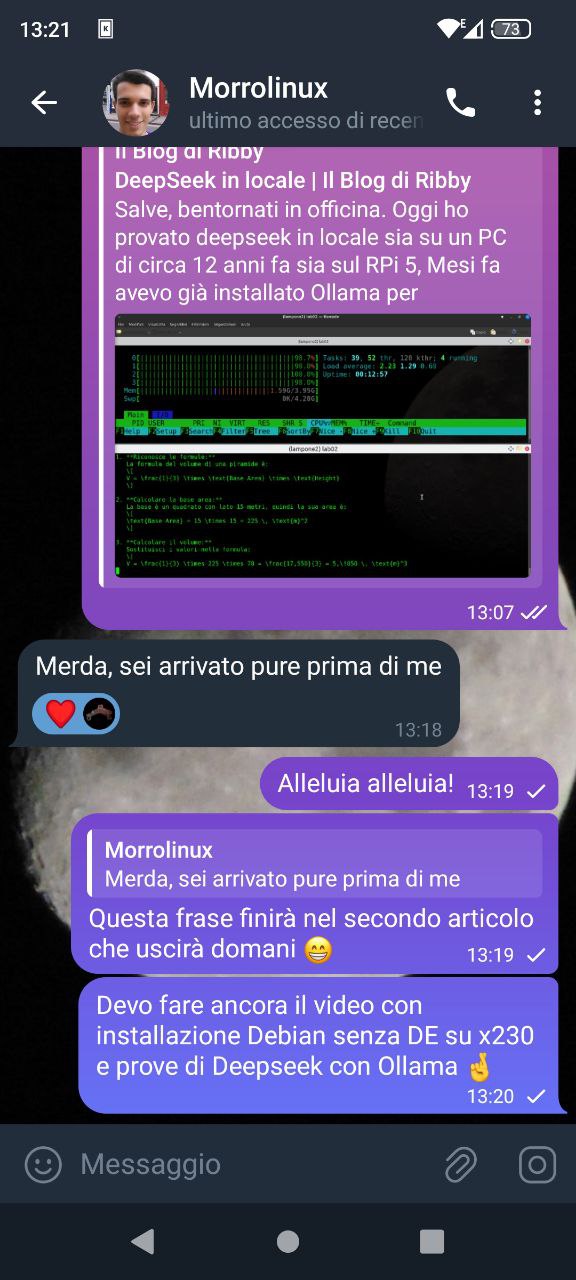
Oggi Lunedi 3 febbraio 2025 ho bubblicato l’articolo “Deepseek in locale” condividendo il link con amici, conoscenti e sui social.
Preso da un attacco di megalomania l’ho invio anche a sue maestà MorroLinux! Che risponde “Merda, sei arrivato pure prima di me”
Allego prova screenshotistica
Questo è il punto più alto della mia carriera informatica 🙂
Sempre oggi ho letto di Velvet un AI svilippata in italiana,
Molto bene 😛
Nei prossimi giorni lavorerò al video del test di Deepseek sul thinkpad X230
Vi aspetto nei commenti per sarepe le vostre opinini
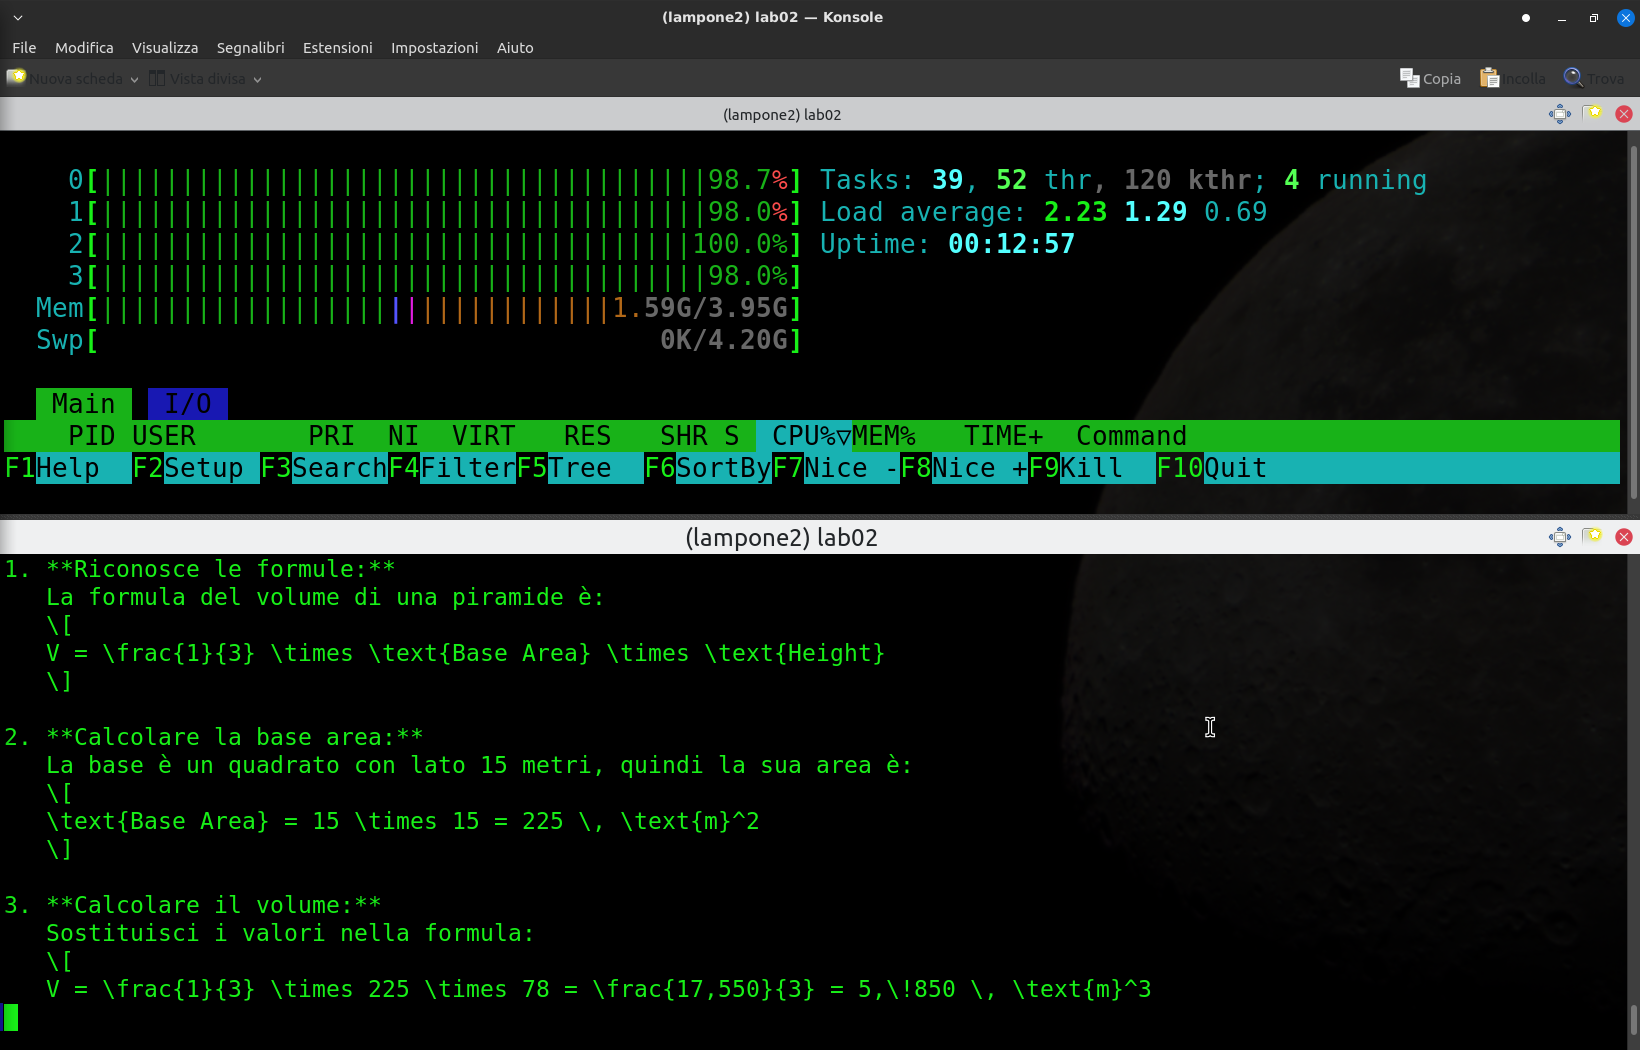
Oggi ho provato deepseek in locale sia su un PC di circa 12 anni fa sia sul RPi 5,
Mesi fa avevo già installato Ollama per provare le LLM leggere ma non erano utlizzabili per vari motivi di lentezza, ram saturata
e poi esplode tutto.
Mentre questo mi ha fatto una buona impressione sia perche non ho avuto errori ne con Ollama ne con Deepseek R1 (1.5 B).
Sul RPi, si avvia e risponde anche in un tempo ragionevole, durante l’elaborazione la CPU va al 100% ma la cosa incredibile è che la ram non viene saturata pur usando il modello da 4Gb,
ho provato anche a fare domande in italiano e sembra comprendere accettabilmente bene anche se le risposte non sono il massimo, mi viene il dubbio che lo stato confuzionale sia sistemico e non dipenda dalla lingua.
Un amico con HW piu prestante ha provato la versione 8B (8 miliardi di parametri) e sembra essere sia piu veloce che avere un italiano migliore,
Quindi come immaginavo diverse di queste pecche si risolveranno con il tempo.
Ora basta con le chiacchiere è arrivato il momento di evocare il terminale
#installare ollama
curl -fsSL https://ollama.com/install.sh | sh
#installare deepseek R1 1.5b
ollama pull deepseek-r1:1.5b
#avviare ollama
sudo systemctl start ollama.service
#avviare deepseek R1 1.5b
ollama run deepseek-r1:1.5b
Apposto! ora potete chattare con deepseek, ovviamente oltre alla versione 1.5b ce ne sono altre gradualmente più performanti e che richiedono HW più potente.